В этой статье рассказываю историю небольшого IoT-проекта, который постепенно вырос из простой идеи в полноценную систему с ESP32, Go backend, мониторингом, инцидентами и уведомлениями. Показываю путь от первой задумки и эмуляции устройства до работающей системы и рассказываю, какие решения пришлось менять по ходу разработки.
У нас есть офис на живописной набережной Ростова-на-Дону. Работаем мы в гибридном формате: можно приехать в офис, а можно остаться работать из дома.
Но периодически возникала одна неприятная ситуация: приезжаешь в офис — а там нет интернета. Иногда вместе с ним нет и электричества.
Причины каждый раз находились разные: плановые ремонтные работы, проблемы у провайдера, а иногда и банальные неуплаченные песо за услуги связи.
Самое неприятное было даже не в самом отсутствии интернета. На большинство этих причин я всё равно никак не мог повлиять. Меня раздражало другое: хотелось заранее понимать, жив ли вообще офис и есть ли там интернет, прежде чем туда ехать.
Казалось бы, задача довольно простая. И решить её можно было множеством уже готовых способов.
Например, можно купить у провайдера белый IP и мониторить доступность офисного роутера извне. Но ради такой задачи связываться с дополнительной услугой, платить за неё и выставлять устройство наружу не хотелось.
Можно установить мониторинг непосредственно на роутер. Хороший вариант, если бы у нас стоял MikroTik, Keenetic или другое устройство, с которым хотелось бы экспериментировать. Но в офисе работает достаточно старый роутер, который при этом прекрасно справляется со своей основной задачей. Здесь действует один из фундаментальных законов системного администрирования:
Если работает — не трогай.
Была даже идея поставить в офис умную колонку и мониторить её доступность через экосистему умного дома. Технически задача решалась бы, но покупать целую умную колонку только для того, чтобы периодически выяснять, жива ли она, выглядело уже слишком большим оверхедом.
Наконец, существовал совсем простой вариант — умная розетка. Подключить через неё роутер и хотя бы понимать, есть ли в офисе электричество.
Наверное, на этом история могла бы закончиться. Но это было бы слишком просто. А как же помучаться?
К тому моменту удачно совпали сразу несколько обстоятельств.
Я проходил курс по IoT и инженерии умного дома, где работал с ESP32, Arduino и Raspberry Pi. Параллельно изучал Go и искал проект, на котором можно было бы применить его не в учебных примерах, а для решения настоящей задачи. Кроме того, мне хотелось попробовать агентный подход к разработке на проекте, который можно целиком контролировать самому.
В результате простая мысль «хочу знать, работает ли интернет в офисе» постепенно превратилась в другую — «а почему бы не собрать собственное устройство мониторинга и не написать для него всю систему целиком — от прошивки до backend?»
Рациональнее ли это покупки умной розетки? Определённо нет. Интереснее? Определённо да.
Итак, решение принято: готовое устройство мы не покупаем — будем собирать своё.
Первоначальный план казался довольно простым. В качестве основы я выбрал ESP32 и отдельную плату расширения с Ethernet. Подключение по кабелю на тот момент выглядело самым надёжным вариантом: устройство должно было физически подключаться к офисному роутеру и становиться ещё одним участником локальной сети.
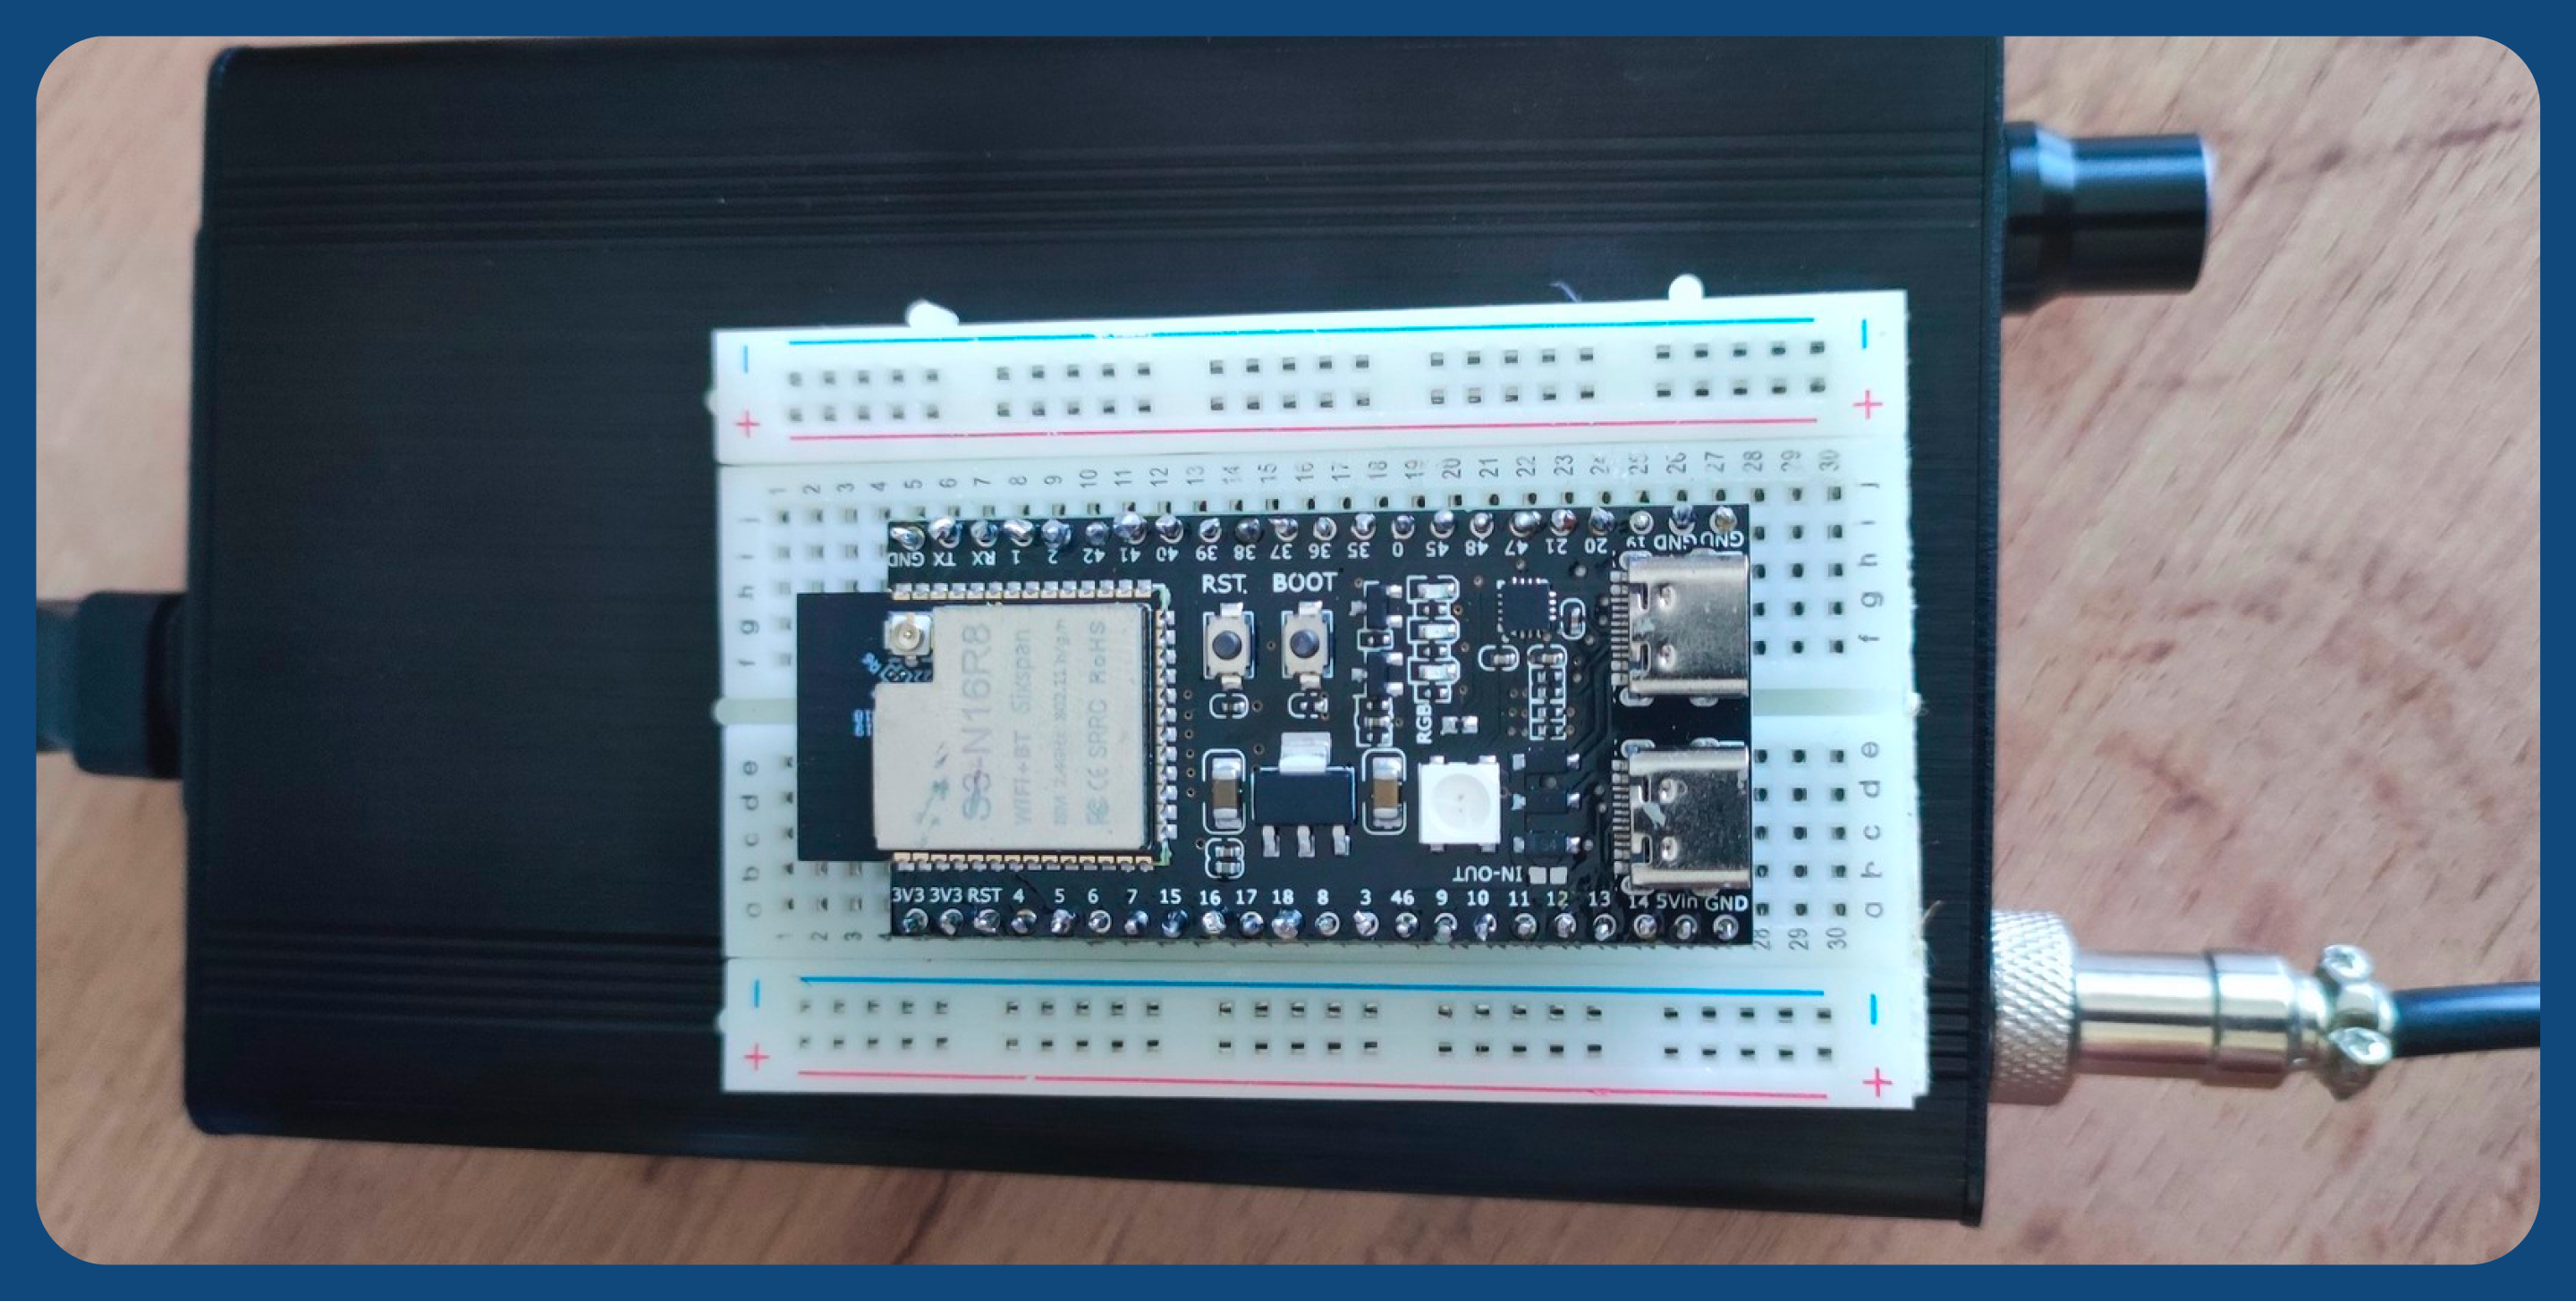
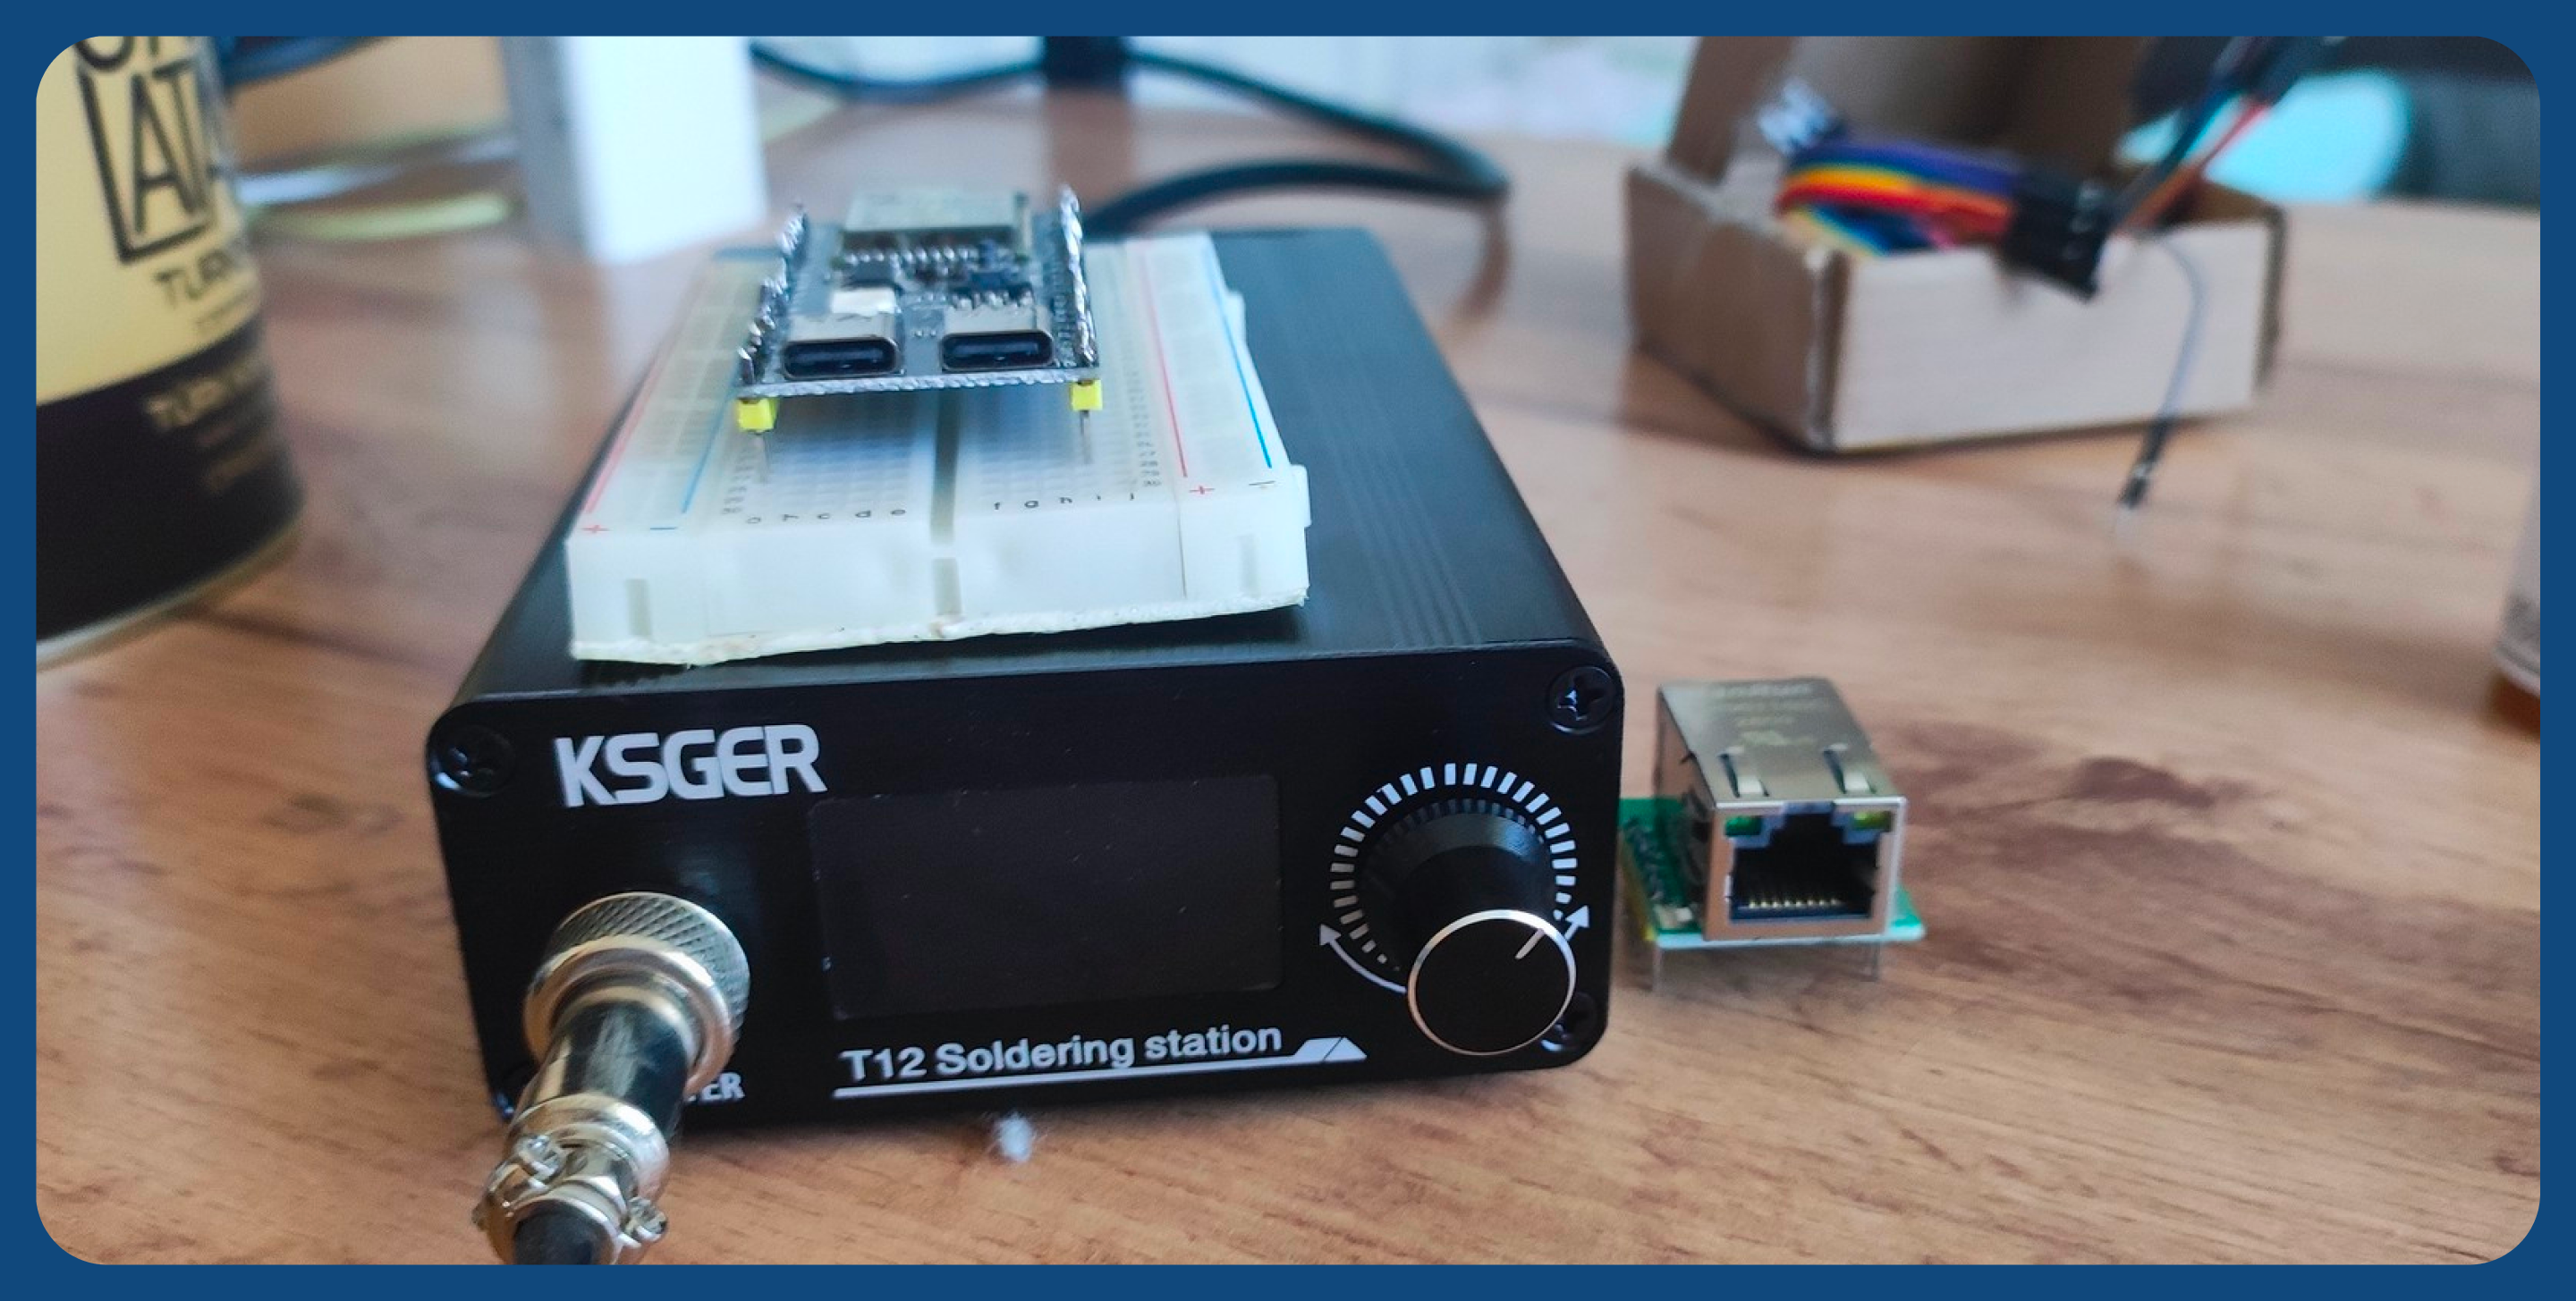
При этом активно сканировать или каким-либо образом нагружать офисную сеть мне не хотелось.
Задача устройства была гораздо проще: периодически сообщать наружу что-то вроде:
Я здесь. Я смог выйти в интернет. Всё в порядке.
То есть вместо того, чтобы пытаться достучаться до офиса извне, я решил развернуть схему наоборот: устройство внутри офиса само должно было периодически обращаться к внешнему серверу.
У такого подхода был ещё один приятный побочный эффект. Не требовался белый IP, не нужно было открывать входящие порты на роутере и вообще выставлять устройство наружу. Для внешнего мира наш маленький монитор мог оставаться обычным клиентом офисной сети.
Оставалась небольшая проблема. У меня ещё не было ни ESP32, ни Ethernet-платы. А делать что-то уже хотелось.
Ждать доставки компонентов показалось слишком скучно, поэтому разработку я решил начать с противоположного конца системы — с backend.
Заодно появился хороший повод использовать Go, который я как раз изучал.
Идея backend была довольно простой: он должен принимать периодические сигналы от устройств и запоминать время последнего успешного обращения.
Причём сразу хотелось не привязывать систему к одной конкретной ESP32. Сегодня устройство одно, а завтра их может оказаться несколько — почему бы сразу не предусмотреть регистрацию устройств и независимый heartbeat для каждого из них?
Базовая логика получалась примерно такой:
Device
   |
   | heartbeat
   v
Backend
   |
   +---- heartbeat пришёл ----> всё хорошо
   |
   `---- heartbeat пропал ----> ждём
                                  |
                                  +---- следующий heartbeat
                                  |
                                  `---- снова тишина
                                           |
                                           v
                                      устройство offline?
Разумеется, настоящего Device у меня всё ещё не было.
Поэтому его место временно занял simulator.
Я сделал программную эмуляцию устройства, которая могла с заданной периодичностью обращаться к backend примерно так, как впоследствии должна была это делать настоящая ESP32.
Получилась немного забавная последовательность разработки: физического устройства ещё не существовало, а сервер уже умел регистрировать устройства, принимать heartbeat, сохранять данные и работать с эмулятором будущего железа.
На этом же этапе появился первый простой Web UI. Никаких сложных dashboard, графиков и аналитики — достаточно было обратиться к backend и показать главное: устройство сейчас выходит на связь или нет.
Так начала складываться первая версия архитектуры:
OFFICE                           VPS

       ┌─────────────────┐
       │     ESP32       │
       │                 │
       │ Ethernet / Wi-Fi│
       └────────┬────────┘
                │
                │ outbound heartbeat
                │
                ▼
          ┌───────────┐
          │ Internet  │
          └─────┬─────┘
                │
                ▼
                              ┌─────────────────────┐
                              │     Go Backend      │
                              │                     │
                              │ registration        │
                              │ heartbeat           │
                              │ device status       │
                              └──────────┬──────────┘
                                         │
                               ┌─────────┴─────────┐
                               ▼                   ▼
                         ┌──────────┐        ┌──────────┐
                         │    DB    │        │  Web UI  │
                         └──────────┘        └──────────┘
И здесь был принципиальный момент всей схемы: сервер не должен был проверять устройство сам.
Никакого подключения к офисной сети извне. Никаких запросов на ESP32. Никаких открытых портов. Направление связи только одно: устройство находится внутри офисной сети и само сообщает внешнему серверу, что оно ещё живо.
Если heartbeat приходит — офис как минимум имеет возможность выйти в интернет. Если перестаёт приходить — значит, что-то произошло.
Что именно — пока неизвестно. Но для первоначальной задачи этого уже было достаточно.
К моменту, когда приехала ESP32, программная часть проекта уже успела заметно продвинуться.
Был Go backend, API для регистрации устройств и heartbeat, база данных, эмуляция устройств и первый workflow обмена данными. То есть сервер уже был готов разговаривать с устройством, которого до этого момента физически не существовало.
Оставалось, казалось бы, самое простое: заменить simulator настоящей ESP32.
Первоначальный план предполагал Ethernet. Я заказал ESP32, отдельный LAN-модуль, припаял необходимые контакты и начал собирать всё вместе.
И здесь план впервые встретился с реальным железом.
Ethernet я выбрал не случайно. Устройство должно было постоянно находиться рядом с роутером, мобильность ему не требовалась, а проводное подключение казалось наиболее предсказуемым вариантом для мониторинга сети.
Логика была примерно такой:
ESP32 ── Ethernet ── Router ── Internet ── VPSНикаких проблем с качеством Wi-Fi, паролями, переподключениями и прочими особенностями беспроводной сети. Воткнул кабель — и устройство работает.
По крайней мере, так это выглядело на бумаге.
На практике подружить ESP32 с купленным LAN-модулем не получилось. После некоторого количества попыток стало понятно, что проблема, скорее всего, находится не в прошивке, а в самом Ethernet-модуле — он оказался бракованным.
Вернуть его к тому моменту уже было поздно.
Передо мной возникло два варианта.
Можно было заказать другой модуль, дождаться доставки и продолжить реализацию первоначального плана.
А можно было посмотреть на ESP32, вспомнить, что Wi-Fi в ней уже есть, и задать себе довольно простой вопрос: а зачем мне вообще сейчас Ethernet?
Да, проводное соединение для такого устройства мне по-прежнему казалось более красивым и предсказуемым решением. Но исходная задача заключалась не в том, чтобы построить идеальный Ethernet-monitor. Мне нужно было понять, доступен ли интернет в офисе. Для этого Wi-Fi подходил ничуть не хуже.
Так Ethernet временно отправился в список вещей, которые можно будет сделать когда-нибудь потом, а первая настоящая версия устройства стала беспроводной.
ESP32
  │
  │ Wi-Fi
  ▼
Office Router
  │
  │ Internet
  ▼
Go Backend
Питание тоже не требовало отдельной инфраструктуры: обычный блок питания и USB Type-C.
И вот здесь пригодилось решение, принятое ещё до приезда железа. Backend не знал и не должен был знать, как именно устройство подключено к сети. До этого его клиентом был simulator. Теперь им стала настоящая ESP32. Для сервера принципиальной разницы практически не было.
Устройство регистрируется, получает необходимые данные для дальнейшей работы и начинает периодически отправлять heartbeat.
Simulator ─┐
           │
           ├──► registration ──► Go Backend
           │
ESP32 ─────┘

ESP32 ─────────► heartbeat ─────► Go Backend
Это был первый момент, когда вся задумка начала работать уже не только в коде.
ESP32 подключалась к офисному Wi-Fi, выходила через него в интернет и обращалась к backend на VPS. А backend видел главное:
устройство вышло на связь.
Значит, как минимум в этот момент ESP32 была включена, офисная Wi-Fi-сеть работала, роутер имел доступ наружу, а запрос смог пройти через интернет до моего сервера.
Для исходной задачи этого было более чем достаточно.
История с Ethernet в итоге оказалась скорее полезной.
Можно было ещё несколько дней разбираться с W5500, проверять SPI, менять конфигурацию, заказывать новый модуль и добиваться первоначально задуманной архитектуры.
Но всё это не приближало бы проект к решению исходной задачи настолько, насколько приближал один работающий Wi-Fi connection.
Это довольно очевидная мысль, которую легко забыть именно в pet-проектах: когда никто не ограничивает сроки и архитектуру, очень легко начать совершенствовать решение проблемы, которая уже перестала быть проблемой.
В моём случае достаточно было оставить Ethernet в покое и использовать то, что уже находилось на плате.
Шалость должна была когда-нибудь начать удаваться.
Первая версия backend появилась ещё до настоящего устройства, и проектировалась она с некоторым запасом.
Несколько устройств, регистрация, heartbeat, хранение состояния — всё это довольно естественно привело к PostgreSQL.
На VPS первоначальная схема выглядела примерно так:
┌───────────────────── VPS ─────────────────────┐
│                                               │
│   ┌──────────────┐        ┌──────────────┐    │
│   │  Go Backend  │───────►│  PostgreSQL  │    │
│   └──────────────┘        └──────────────┘    │
│                                               │
└───────────────────────────────────────────────┘
И технически с ней всё было нормально. Проблема заключалась в другом. В какой-то момент я посмотрел на то, что получилось, и задал себе очередной неприятный вопрос: а зачем мне здесь PostgreSQL?
У меня одна ESP32. Один backend. Один небольшой VPS. Раз в несколько секунд приходит крошечный heartbeat.
Нет сложной аналитики. Нет тяжёлых запросов. Нет десятков пользователей. Нет необходимости масштабировать backend на несколько экземпляров. И ради всего этого рядом работает отдельный контейнер PostgreSQL.
Конечно, можно было оставить всё как есть. PostgreSQL прекрасно справлялся с задачей. Но «справляется» ещё не означает «нужен».
У проекта с самого начала была одна важная оговорка: это эксперимент.
Если идея окажется полезной и когда-нибудь перерастёт в полноценную систему мониторинга с большим количеством устройств, метриками, графиками, аналитикой и другими требованиями — можно будет спроектировать такую систему отдельно.
Не было никакого смысла пытаться заранее построить её внутри маленького pet-проекта.
Поэтому PostgreSQL я убрал. Его место заняла SQLite.
┌──────────────────── VPS ──────────────────────┐
│                                               │
│   ┌───────────────────────────────────────┐   │
│   │              Go Backend               │   │
│   │                                       │   │
│   │  API + device logic + Web UI          │   │
│   │                 │                     │   │
│   │                 ▼                     │   │
│   │             SQLite                    │   │
│   └───────────────────────────────────────┘   │
│                                               │
└───────────────────────────────────────────────┘
Вместо двух сервисов на VPS остался один контейнер backend и persistent volume с файлом SQLite. И для текущей нагрузки этого оказалось более чем достаточно.
Примерно по той же причине я не стал превращать Web UI в отдельный frontend-проект. Мне не требовались React, Vue, отдельный Node.js build, frontend-контейнер и собственный deployment pipeline. Мне нужно было открыть страницу и увидеть состояние устройства.
Поэтому UI остался обычным HTML, CSS и JavaScript, который раздаёт тот же Go backend. Получилась очень простая конструкция:
Browser
   │
   │ HTTPS
   ▼
┌───────────────────┐
│    Go Backend     │
│                   │
│  REST API         │
│  Device logic     │
│  Monitor UI       │
│       │           │
│       ▼           │
│     SQLite        │
└───────────────────┘
Не самая впечатляющая архитектурная диаграмма. И в этом как раз её преимущество. Для моих задач она закрывала всё необходимое с огромным запасом.
Навести красоту всегда можно потом.
Добавить полноценные временные ряды. Построить графики доступности. Посчитать SLA. Подключить отдельную систему метрик. Вернуть PostgreSQL. Разделить frontend и backend. Добавить ещё несколько сервисов.
Список потенциальных улучшений у разработчика обычно заканчивается значительно позже, чем свободное время. Поэтому на этом этапе я решил остановиться.
Мне был важен сам факт: устройство стоит в офисе, выходит в интернет и сообщает о себе внешнему серверу. Если для решения задачи достаточно одного Go-процесса и SQLite, значит именно столько инфраструктуры ей сейчас и нужно.
Меньше планировать идеальную систему. Больше делать работающую.
Как выяснилось чуть позже, остановиться на этом всё равно не получилось.
На этом первоначальную задачу уже можно было считать решённой.
ESP32 стояла в офисе, подключалась к Wi-Fi и периодически отправляла heartbeat на мой VPS. Backend сохранял данные, а через простой Web UI я мог посмотреть состояние устройства.
То есть перед поездкой в офис уже можно было ответить на тот самый вопрос, с которого всё началось:
Но примерно в этот момент у проекта появился ещё один пользователь. Вернее, сразу вся компания.
У нашей компании есть собственные разработки — в частности, LightPulse и LightTeams.
Когда руководитель увидел идею с отдельным устройством мониторинга, появилась дополнительная задача: если ESP32 всё равно периодически проверяет возможность выйти из офисной сети наружу, почему бы не использовать этот сигнал ещё и внутри корпоративной экосистемы?
Так у устройства появился второй независимый маршрут.
Первый остался прежним — частый heartbeat на мой backend:
ESP32
   │
   │ heartbeat
   ▼
VPS
   │
   ├── Go Backend
   ├── SQLite
   └── Monitor UI
А второй стал корпоративным: с гораздо большей периодичностью устройство должно было обращаться к LightPulse.
┌──────► My VPS
                  │        heartbeat
                  │
Office ESP32 ─────┤
                  │
                  └──────► LightPulse
                           monitoring signal
Для LightPulse не было необходимости получать heartbeat каждые несколько секунд. Достаточно было периодического сигнала примерно раз в 30–40 минут.
Смысл этого запроса оставался тем же:
Значит, с очень высокой вероятностью офис сейчас онлайн.
Но теперь эта информация перестала быть доступна только мне через мой маленький Web UI.
Благодаря существующей интеграции LightPulse с Mattermost сигнал можно было использовать уже внутри привычной корпоративной инфраструктуры и давать информацию о состоянии офиса остальным сотрудникам.
И здесь маленький эксперимент неожиданно начал превращаться в настоящий внутренний инструмент.
При этом я сознательно не стал объединять два сценария в один.
Мой backend и LightPulse решали разные задачи.
Частый heartbeat нужен локальной системе мониторинга, чтобы относительно быстро заметить исчезновение устройства.
ESP32 ── 5 sec ──► VPSКорпоративному сервису такая частота совершенно не требовалась:
ESP32 ── 30–40 min ──► LightPulseВ результате одна маленькая ESP32 стала выполнять сразу две функции. Для моей системы она оставалась постоянно работающим probe, по которому можно определить текущее состояние офисной сети. Для корпоративной инфраструктуры — источником периодического сигнала о том, что офис доступен.
И всё это по-прежнему работало по первоначальному принципу проекта:
Устройство само инициирует оба соединения наружу и сообщает:
На этом можно было бы действительно остановиться.
У меня было физическое устройство, работающий backend, база данных, Web UI и даже интеграция с корпоративной системой. Но появилась новая проблема.
Я мог открыть страницу и увидеть, что устройство перестало выходить на связь. Вот только для этого мне сначала нужно было самому открыть страницу.
К этому моменту система уже умела отвечать на главный вопрос: когда ESP32 последний раз выходила на связь.
Можно открыть Web UI, посмотреть время последнего heartbeat и понять, всё ли в порядке. Но довольно быстро обнаружилась очевидная проблема такого подхода. Чтобы узнать, что интернет в офисе пропал, мне сначала нужно было самостоятельно вспомнить про мониторинг, открыть страницу и посмотреть состояние устройства.
Получался мониторинг, за которым нужно мониторить.
Так появилась следующая задача: система должна сама определять проблему и сообщать о ней. На первый взгляд всё опять кажется довольно просто. Не пришёл heartbeat — устройство offline. Но здесь начались уже более интересные вопросы.
ESP32 отправляет heartbeat достаточно часто. Но считать устройство недоступным после первого же пропущенного запроса было бы слишком агрессивно.
Запрос может потеряться. Wi-Fi может кратковременно переподключиться. VPS может ответить чуть позже. Может произойти временная сетевая ошибка где-нибудь между Ростовом и сервером.
Само устройство при этом совершенно исправно.
Поэтому модель:
heartbeat пропал
       │
       ▼
    OFFLINE
мне не подходила.
Вместо этого появился offline threshold.
Backend знает время последнего принятого heartbeat и периодически проверяет, сколько времени прошло с момента последнего успешного сигнала.
heartbeat
   │
   ▼
last_seen
   │
   │
   │     now - last_seen
   ▼
┌──────────────────────┐
│ меньше threshold?    │──── yes ───► ONLINE
└──────────┬───────────┘
           │ no
           ▼
        OFFLINE
То есть отдельный неудачный запрос ничего не меняет. Система даёт устройству время самостоятельно восстановить связь и только после превышения заданного порога считает ситуацию настоящей проблемой.
Так обычный last heartbeat начал превращаться в мониторинг состояния.
Следующий вопрос возник практически сразу. Допустим, устройство признано offline. Через некоторое время backend снова запускает проверку.
Устройство всё ещё offline. Ещё через некоторое время — снова offline.
Если каждый такой результат считать новым событием, одна проблема быстро превратится в десятки одинаковых записей и уведомлений. Поэтому понадобилось понятие инцидента.
Первое обнаружение проблемы открывает connectivity incident:
ONLINE
   │
   │ heartbeat отсутствует дольше threshold
   ▼
OFFLINE
   │
   ▼
OPEN INCIDENT
Пока этот incident остаётся открытым, последующие проверки уже не создают новые.
Система знает:
Таким образом, состояние устройства и история проблем перестали быть одним и тем же. Устройство может быть offline прямо сейчас, а incident хранит сам факт того, когда эта проблема началась и когда закончилась. Это оказалось полезнее первоначального простого last_seen.
Теперь система постепенно начинала отвечать уже на другие вопросы:
И это уже было значительно ближе к настоящему мониторингу.
А когда считать устройство восстановленным? Здесь появилась симметричная проблема. Если одного пропущенного heartbeat недостаточно для объявления аварии, стоит ли считать устройство восстановленным после первого же успешного запроса?
Представим нестабильное соединение:
OFFLINE

heartbeat ✓
heartbeat ✗
heartbeat ✗
heartbeat ✓
heartbeat ✗
Если переключать состояние после каждого отдельного сигнала, устройство начнёт прыгать между online и offline. Поэтому для восстановления появился ещё один простой механизм: несколько последовательных успешных heartbeat.
Например:
OFFLINE
   │
   ├── heartbeat ✓  1/3
   │
   ├── heartbeat ✓  2/3
   │
   └── heartbeat ✓  3/3
                      │
                      ▼
                   ONLINE
                      │
                      ▼
               INCIDENT RESOLVED
Только после нескольких успешных сигналов подряд backend считает соединение восстановленным и закрывает открытый incident.
Получился небольшой state machine:
heartbeat timeout
        ┌────────────────────────────┐
        │                            ▼
     ONLINE                       OFFLINE
        ▲                            │
        │                            │
└──── N good heartbeats ─────┘Оставался последний очевидный недостаток. Backend теперь сам понимал, что произошёл incident. Но я всё ещё мог узнать об этом только через Web UI. Значит, пришло время уведомлений.
Сначала я специально отделил сам механизм обнаружения incident от способа доставки уведомления. Для backend не должно быть принципиальной разницы, куда сообщать о событии:
┌──► Web Push
                  │
Incident ─────► Dispatcher ──► Email?
                  │
                  └──► что-нибудь ещё?
Первым реальным каналом стал Web Push. И вот здесь маленький backend, который просто принимал heartbeat от ESP32, внезапно потребовал ещё несколько вполне взрослых компонентов.
Нужно было хранить push subscriptions. Нужен был service worker в браузере. Понадобились VAPID-ключи. Нужно было корректно удалять больше не существующие subscriptions. А главное — браузерные Web Push API требуют secure context. То есть появился HTTPS.
ESP32
   │
   │ heartbeat
   ▼
 Internet
   │
   ▼
┌──────────────────────────── VPS ────────────────────────────┐
│                                                            │
│   HTTPS                                                    │
│     │                                                      │
│     ▼                                                      │
│ Reverse Proxy                                              │
│     │                                                      │
│     ▼                                                      │
│ Go Backend ─────► SQLite                                   │
│     │                                                      │
│     ├────► Incident Detector                               │
│     │            │                                         │
│     │            ▼                                         │
│     │        Dispatcher                                    │
│     │            │                                         │
│     │            ▼                                         │
│     └────────► Web Push ─────────────► Browser / Phone      │
│                                                            │
└────────────────────────────────────────────────────────────┘
И где-то примерно здесь я в очередной раз вспомнил, с чего всё начиналось. Я просто хотел перед поездкой в офис узнать, работает ли там интернет.
Теперь у меня были ESP32, Go backend, SQLite, incident lifecycle, recovery logic, reverse proxy, TLS, service worker и push-уведомления. Кажется, умная розетка всё-таки была немного проще.
После всех экспериментов, отказов от первоначальных решений и постепенно появлявшихся требований архитектура в итоге стала даже проще, чем на некоторых промежуточных этапах. В офисе осталось одно небольшое устройство на ESP32-S3.
Никакого Ethernet-модуля. Никакого белого IP. Никаких открытых портов и возможности подключиться к устройству извне.
ESP32 подключается к обычной офисной Wi-Fi-сети и сама инициирует все необходимые соединения. На VPS работает один контейнер с Go backend. Он же раздаёт Web UI, выполняет логику мониторинга и работает с SQLite.
Отдельно существует LightPulse, куда устройство отправляет более редкий корпоративный monitoring signal.
Если собрать всё вместе, схема выглядит примерно так:
OFFICE

                  ┌─────────────────┐
                  │    ESP32-S3     │
                  │                 │
                  │     Wi-Fi       │
                  └────────┬────────┘
                           │
                           ▼
                  ┌─────────────────┐
                  │ Office Router   │
                  └────────┬────────┘
                           │
                           │ outbound only
                           ▼
                       Internet
                           │
             ┌─────────────┴──────────────┐
             │                            │
             ▼                            ▼

           VPS                        LightPulse
             │
             ▼
      ┌───────────────┐
      │ Reverse Proxy │
      │     HTTPS     │
      └───────┬───────┘
              │
              ▼
      ┌──────────────────────┐
      │      Go Backend      │
      │                      │
      │ registration         │
      │ heartbeat            │
      │ device status        │
      │ incident detection   │
      │ recovery             │
      │ Web Push             │
      │ Monitor UI           │
      └──────────┬───────────┘
                 │
                 ▼
             ┌────────┐
             │ SQLite │
             └────────┘
Самое интересное здесь, пожалуй, не количество компонентов, а то, что офисная сеть по-прежнему ничего не принимает извне. ESP32 сама обращается к внешним сервисам. Это позволяет не решать отдельную задачу удалённого доступа к офису.
После включения ESP32 подключается к офисному Wi-Fi и начинает работать как обычный клиент сети. Дальше устройство периодически отправляет heartbeat на backend:
ESP32
  │
  ├── heartbeat ─────────────► VPS
  │
  ├── heartbeat ─────────────► VPS
  │
  ├── heartbeat ─────────────► VPS
  │
  └── ...
Каждый успешно полученный heartbeat означает довольно простую вещь.
В этот момент одновременно выполняется несколько условий:
ESP32 работает
      +
Wi-Fi работает
      +
роутер работает
      +
есть доступ в интернет
      +
VPS доступен
      =
heartbeat получен
Это не позволяет определить качество интернет-соединения или измерить его скорость. Но такой задачи перед устройством и не ставилось. Мне нужен был бинарный ответ на гораздо более простой вопрос:
Если heartbeat перестаёт приходить, backend не объявляет аварию немедленно. Он ждёт установленный timeout.
heartbeat ✓
heartbeat ✓
heartbeat ✓
     │
     │ связь пропала
     ▼
   silence
     │
     │ threshold exceeded
     ▼
   OFFLINE
     │
     ▼
incident opened
     │
     ▼
notification
При этом backend не знает причину отсутствия heartbeat. И это важно. Устройство могло потерять Wi-Fi. Мог отключиться роутер. Мог упасть интернет у провайдера. Могло исчезнуть электричество во всём офисе. В конце концов, сама ESP32 могла перестать работать.
Для системы все эти ситуации выглядят одинаково: устройство давно не может сообщить о себе.
Но для исходной задачи мне и не требуется устанавливать точную причину. Если ESP32, которая физически находится в офисе и питается от офисной электросети, продолжительное время не может обратиться к внешнему серверу — ехать туда, рассчитывая на нормальную работу, как минимум подозрительно.
А разбираться в конкретной причине можно уже после.
Когда связь возвращается, первый успешный heartbeat ещё не закрывает incident. Backend ждёт несколько последовательных успешных сигналов.
OFFLINE

   heartbeat ✓
        │
       1/N

   heartbeat ✓
        │
       2/N

   heartbeat ✓
        │
       N/N
        │
        ▼
      ONLINE
        │
        ▼
incident resolved
Это защищает систему от ситуации, когда нестабильное соединение постоянно переключает устройство между online и offline. Таким образом, вокруг очень простого heartbeat появилась небольшая модель жизненного цикла:
┌──────────── ONLINE ◄─────────────┐
        │                                  │
        │                                  │
        │ timeout                          │ N successful
        │                                  │ heartbeats
        ▼                                  │
OFFLINE ───────► OPEN INCIDENT ───────┘Кроме частого heartbeat на мой backend, ESP32 периодически обращается к LightPulse. Это уже другой сценарий.
┌── frequent ──► Monitoring Backend
                   │
ESP32 ─────────────┤
                   │
                   └── 30–40 min ─► LightPulse
Моему backend нужен частый сигнал, потому что его задача — относительно быстро обнаружить потерю связи. LightPulse решает другую задачу, поэтому отправлять туда запрос каждые несколько секунд нет никакого смысла. Получается интересная ситуация: физически probe один, но сигнал от него используется двумя независимыми системами с разными требованиями.
После появления настоящей ESP32 эмулятор устройства тоже не стал бесполезным. Наоборот, теперь он позволял работать с backend без физического доступа к офисному устройству.
Можно запустить simulator локально, зарегистрировать виртуальное устройство и воспроизвести тот же базовый lifecycle:
register
   │
   ▼
heartbeat
   │
   ▼
telemetry / events
   │
   ▼
stop simulator
   │
   ▼
offline
   │
   ▼
start again
   │
   ▼
recovery
Для разработки backend это оказалось намного удобнее, чем при каждом изменении перепрошивать ESP32, подключать её к сети и ждать необходимого состояния.
В каком-то смысле временная заглушка, которую я написал только потому, что железо слишком долго ехало, стала полноценным инструментом разработки.
Здесь есть одна важная оговорка. Я несколько раз называл устройство монитором интернета, но технически это не совсем точное определение. ESP32 не измеряет SLA провайдера. Не запускает Speedtest. Не анализирует packet loss. Не строит traceroute. Не проверяет каждый компонент офисной сети отдельно.
Она отвечает на гораздо более узкий вопрос:
Именно поэтому отсутствие heartbeat нельзя автоматически трактовать как: провайдер снова уронил интернет.
Причина может находиться где угодно на пути:
ESP32
  │
Wi-Fi
  │
Router
  │
ISP
  │
Internet
  │
VPS
Но для первоначальной задачи это оказалось даже преимуществом. Мне ведь хотелось знать не состояние договора с провайдером и не latency последней мили.
Мне хотелось знать: если я сейчас приеду в офис и открою ноутбук — есть ли основания ожидать, что там вообще всё работает?
И с этим маленькая ESP32 справляется вполне успешно.
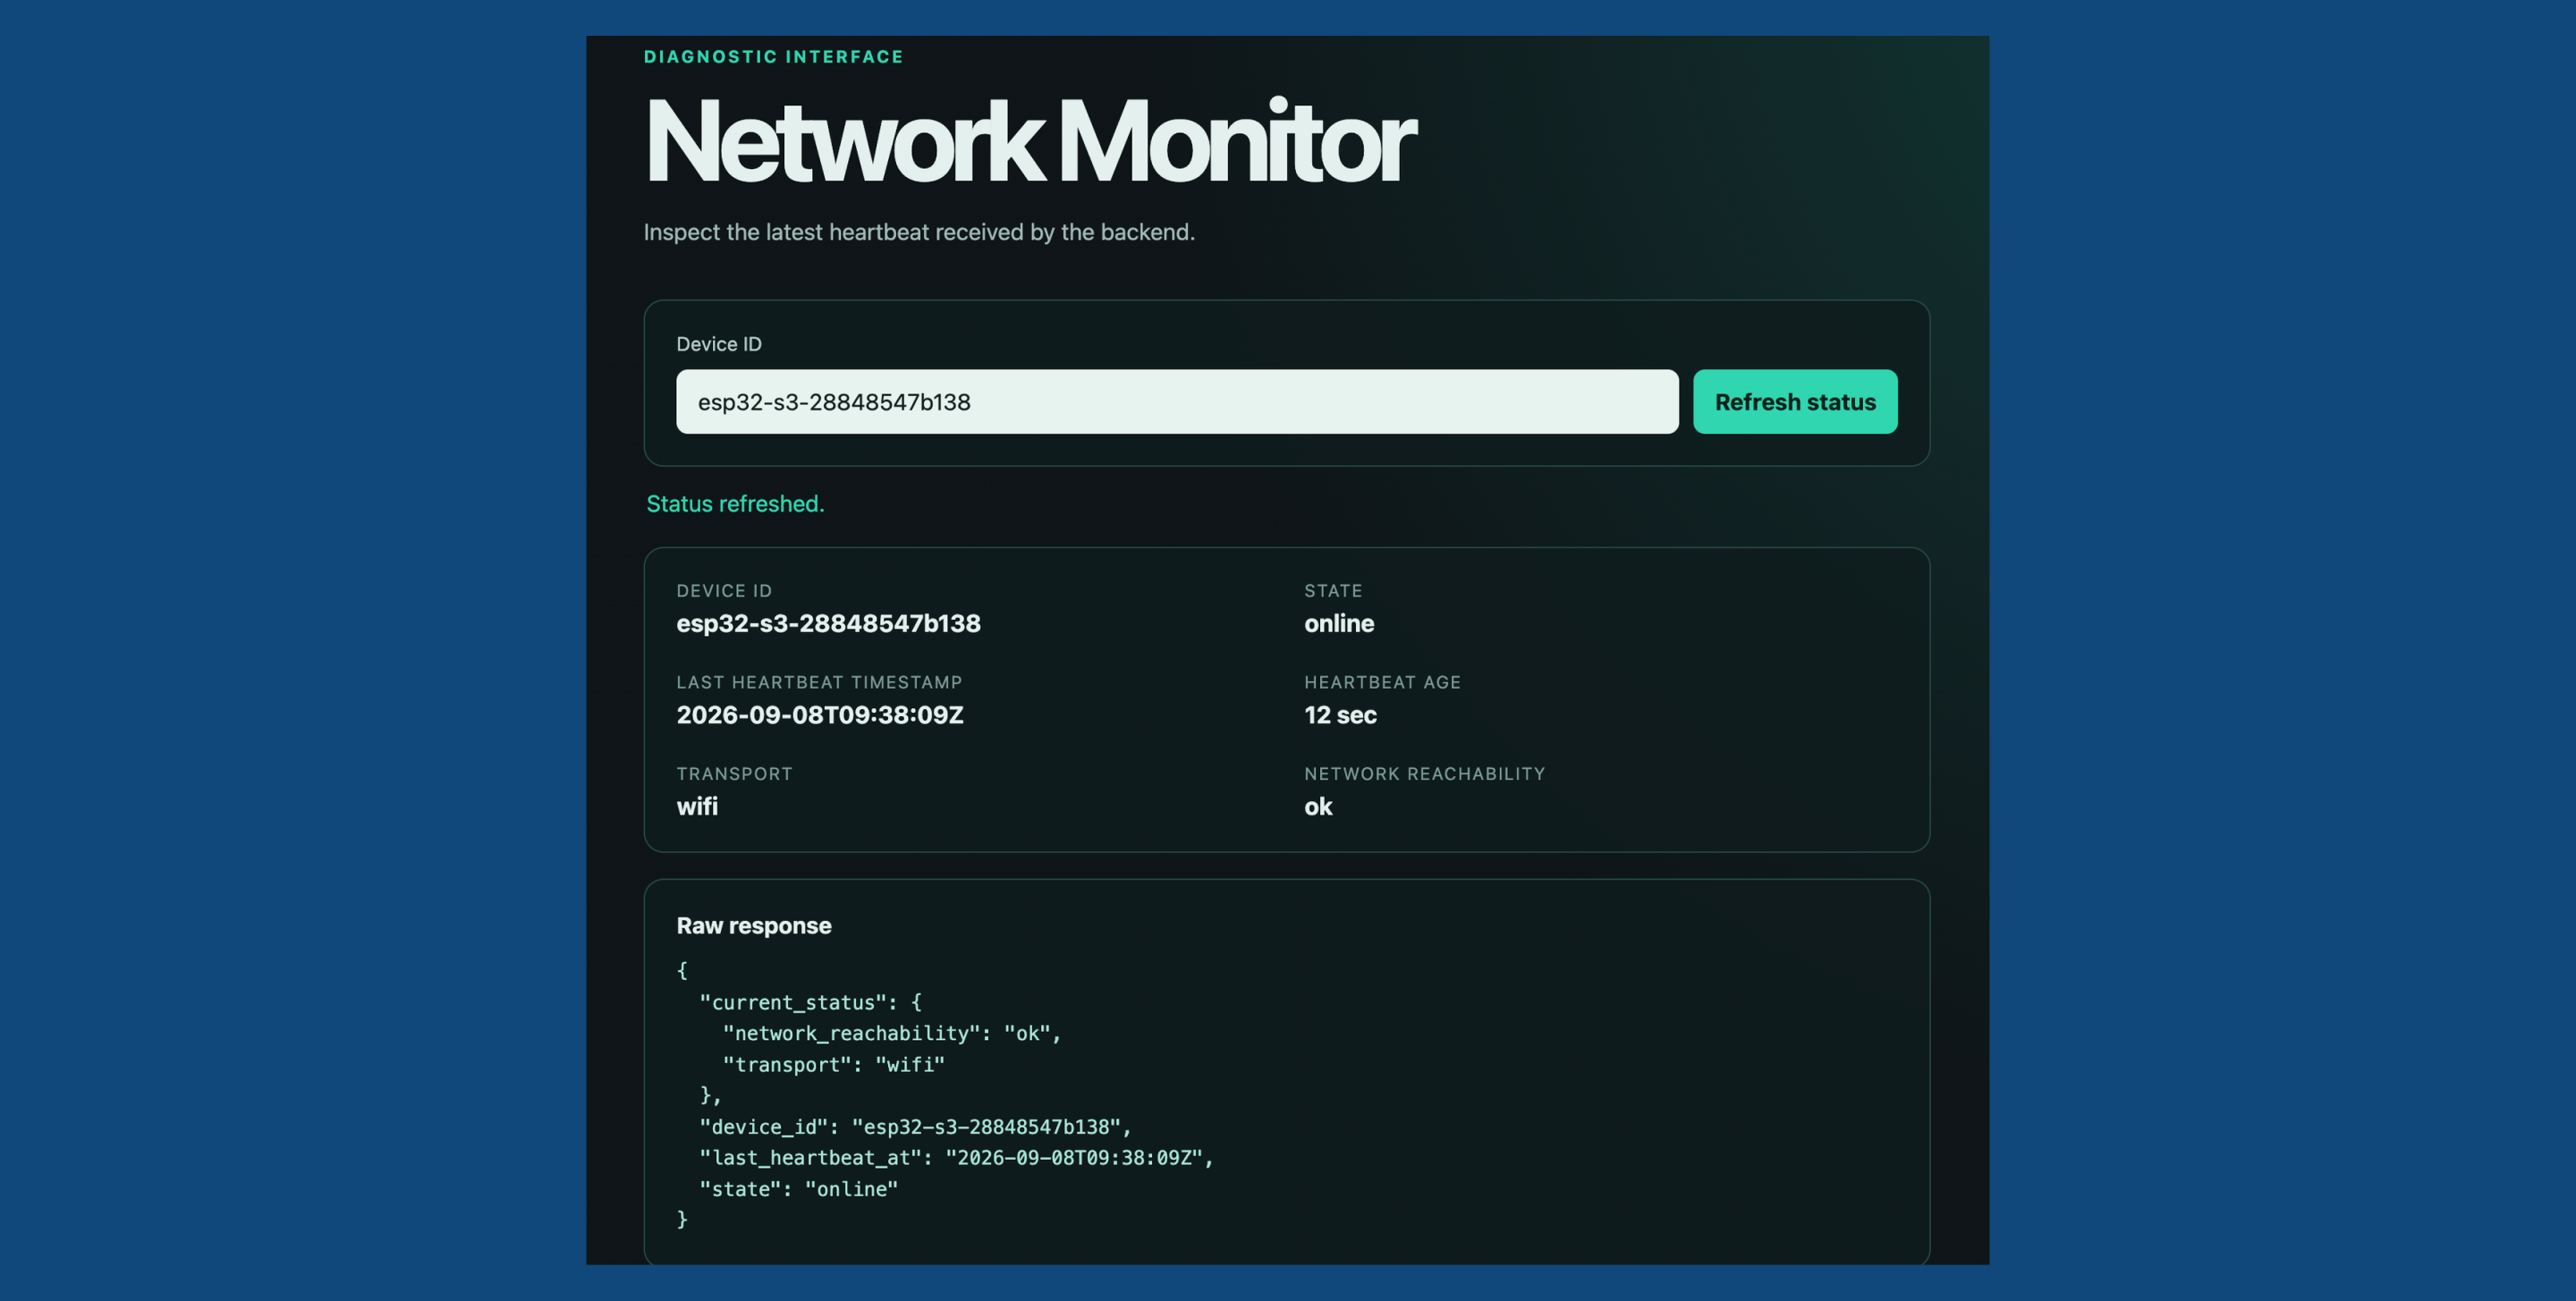
Технически этот проект нельзя назвать особенно сложным. ESP32 отправляет HTTP-запросы. Go принимает их. SQLite сохраняет данные. Несколько простых правил определяют состояние устройства, а Web Push сообщает о проблеме.
Но именно небольшие проекты иногда оказываются хорошим местом для проверки инженерных идей. Здесь можно ошибиться с архитектурой, выбросить половину первоначального решения и попробовать что-то новое без нескольких недель согласований и миграционного плана на следующий квартал.
У меня таких экспериментов получилось сразу несколько.
Первоначально в проекте появился PostgreSQL. И это было вполне нормальным техническим решением. Можно было оставить его, добавить нормальную систему миграций, вынести frontend, подготовить инфраструктуру для нескольких backend instances, добавить Redis, очередь сообщений и постепенно получить архитектуру, способную обслуживать тысячи устройств.
Оставалась только одна проблема. У меня было одно устройство. Поэтому в какой-то момент полезнее оказалось не спрашивать: как правильно построить такую систему?
А спросить: что действительно требуется этой системе сейчас?
Ответ оказался довольно скромным:
1 × ESP32
1 × VPS
1 × Go backend
1 × SQLite
Если когда-нибудь устройств станет тысяча — это будет хорошая проблема. И решать её имеет смысл тогда, когда она появится.
В программной разработке мы привыкли к тому, что большая часть окружения довольно предсказуема. С железом всё веселее.
Можно выбрать Ethernet, написать под него код, продумать подключение — а потом получить неисправный модуль.
Первой реакцией разработчика вполне может быть желание всё-таки заставить первоначальный план работать. Найти другой модуль. Перепроверить SPI. Ещё раз изучить документацию. Заказать новую плату. Но иногда гораздо полезнее снова посмотреть на исходное требование.
Мне нужен Ethernet? Или мне нужен способ понять, что офис может выйти в интернет?
Если второе — встроенный Wi-Fi решает задачу уже сегодня. В результате бракованный Ethernet-модуль неожиданно оказался хорошим архитектурным ревьюером.
Первоначальную проблему можно было решать с другой стороны. Получить белый IP. Открыть необходимый порт. Настроить доступ к роутеру или самому устройству. После этого внешний сервис мог бы периодически проверять офис. Я пошёл в противоположную сторону.
не так:

Internet ─────► Office

а так:

Office ─────► Internet
ESP32 сама инициирует соединение с внешним backend. Это сильно упростило всю конструкцию. Не нужно знать внешний адрес офиса. Не нужно принимать входящие соединения. Не нужно выставлять ESP32 наружу. Не нужно отдельно решать NAT.
Для внешней сети устройство остаётся обычным клиентом, который время от времени выполняет HTTP-запрос. При этом для поставленной задачи информации от такого запроса вполне достаточно.
Simulator появился не в результате какого-то серьёзного архитектурного планирования.
Причина была значительно прозаичнее: железо ещё не приехало, а программировать уже хотелось.
Поэтому я сделал виртуальное устройство и начал строить backend вокруг него. Но временное решение осталось полезным и после появления настоящей ESP32.
Это позволило разделить две вещи:
DEVICE PROTOCOL             PHYSICAL DEVICE

registration                ESP32-S3
heartbeat                   Wi-Fi
telemetry                   ESP-IDF
events                      GPIO / hardware
commands
Для проверки backend мне больше не обязательно физическое устройство. Я могу запустить simulator, создать несколько виртуальных устройств, остановить одно из них, проверить offline detection, восстановить его и посмотреть lifecycle целиком.
А настоящее железо нужно уже тогда, когда я проверяю именно hardware-specific поведение. Получился подход, который я совершенно точно буду использовать и в следующих подобных проектах:
POST /heartbeatПолучили запрос — устройство работает.
Но достаточно задать следующий вопрос: а что делать, если запрос не пришёл?
И сразу появляются timeout, offline threshold, incident lifecycle, recovery policy и защита от повторных событий.
heartbeat
    │
    ▼
last seen
    │
    ▼
threshold
    │
    ▼
offline
    │
    ▼
incident
    │
    ▼
notification
    │
    ▼
recovery
Сам HTTP endpoint оказался самой неинтересной частью. Интерес начинается вокруг определения состояния системы по неполному и потенциально нестабильному сигналу. И это уже проблема далеко не только IoT.
У этого проекта с самого начала была ещё одна цель.
Мне хотелось использовать его как полигон сразу для нескольких направлений.
Я изучал IoT и хотел наконец сделать что-нибудь с ESP32, что будет решать настоящую задачу, а не заканчивать жизнь после выполнения очередной лабораторной работы.
Параллельно я изучал Go и хотел написать на нём что-то большее, чем учебный HTTP-сервер.
А ещё мне хотелось проверить агентный workflow разработки. Последнее в итоге стало отдельным экспериментом внутри эксперимента.
Вместо того чтобы просто ставить агенту задачу вроде «сделай уведомления», я постепенно пришёл к тому, чтобы разделять работу на отдельные роли и этапы:
исследование
     │
     ▼
планирование
     │
     ▼
реализация
     │
     ▼
тестирование
     │
     ▼
review
     │
     ▼
исправления
     │
     ▼
документация
Для маленького проекта такой процесс может выглядеть избыточно. Но именно здесь его и было удобно проверять.
Цена ошибки небольшая, весь код находится перед глазами, а результат работы агента можно сравнить не с абстрактной оценкой «вроде работает», а с конкретным физическим устройством.
ESP32 либо отправляет heartbeat, либо нет. Incident либо открывается, либо нет. Push либо приходит, либо нет.
В результате сам проект стал не только экспериментом с IoT, но ещё и полигоном для того, как я хочу организовывать работу с coding agents в более крупных проектах.
Наверное, это главный вывод всей истории. Сейчас в проект можно добавить ещё очень много всего:
Можно вернуть Ethernet. Можно вообще спроектировать собственную плату и напечатать для неё красивый корпус. И почти каждое такое улучшение можно технически обосновать. Но исходная задача уже решена. Устройство стоит в офисе. Оно самостоятельно выходит в интернет. Сервер понимает, когда связь пропадает. Я могу посмотреть текущее состояние.
Система умеет сообщить о проблеме. LightPulse получает свой периодический сигнал. Значит, в какой-то момент нужно перестать проектировать следующую версию и признать: шалость удалась.
Когда основная часть проекта уже заработала, осталась ещё одна довольно практическая проблема. Разрабатывать всё это я начал на MacBook с Apple Silicon. Backend здесь никаких особых сюрпризов не преподносил: Go, Docker, SQLite — обычная рабочая среда. С ESP32 всё оказалось немного интереснее.
Для разработки firmware используется ESP-IDF — официальный framework и toolchain для ESP32. Его можно установить непосредственно на macOS, настроить зависимости, Python environment, toolchain и работать локально.
Но мне хотелось другого. После экспериментов с окружением мы пришли к довольно удобной схеме: не устанавливать и не поддерживать весь ESP-IDF toolchain на основной системе, а выполнять сборку firmware внутри Docker.
Получается примерно так:
┌──────────────────── MacBook / Apple Silicon ────────────────────┐
│                                                                 │
│   Source code                                                   │
│   firmware/                                                     │
│       │                                                         │
│       │ mount                                                   │
│       ▼                                                         │
│   ┌──────────────────────────────┐                              │
│   │          Docker              │                              │
│   │                              │                              │
│   │          ESP-IDF             │                              │
│   │             │                │                              │
│   │             ▼                │                              │
│   │        idf.py build          │                              │
│   │             │                │                              │
│   │             ▼                │                              │
│   │       firmware.bin           │                              │
│   └──────────────────────────────┘                              │
│                 │                                               │
│                 ▼                                               │
│             ESP32-S3                                            │
│              USB-C                                              │
│                                                                 │
└─────────────────────────────────────────────────────────────────┘
У такого подхода оказался приятный побочный эффект. Среда сборки firmware становится практически частью самого проекта. Не нужно вспоминать, какую версию ESP-IDF я устанавливал полгода назад, какие Python-пакеты потребовались, какой toolchain лежит в системе и что я когда-то добавлял в PATH.
Есть исходный код. Есть известная версия ESP-IDF. Есть контейнер. Можно воспроизвести сборку.
Здесь, правда, обнаруживается интересная особенность macOS.
Docker Desktop на Mac работает не непосредственно на ядре macOS, а через Linux VM. Поэтому привычная для Linux идея:
docker run --device=/dev/ttyUSB0 ...с USB/serial-устройствами на macOS превращается уже не в настолько очевидную историю. А ESP32 нужно не только собрать. Её ещё нужно прошить.
В итоге удобно разделить процесс на две части:
BUILD                         FLASH

Firmware ─────────────► Docker ─────────────► binaries
                         ESP-IDF                  │
                                                  │
                                                  ▼
                                               macOS
                                                  │
                                               serial
                                                  │
                                                  ▼
                                              ESP32-S3
Docker отвечает за воспроизводимую среду сборки с ESP-IDF. А непосредственную работу с serial-портом можно оставить хостовой системе и использовать отдельный инструмент для прошивки. В моём случае таким инструментом стал espflash.
Получился достаточно удобный компромисс:
ESP-IDF
   │
   │ Docker
   ▼
build firmware
   │
   ▼
*.bin
   │
   │ macOS + espflash
   ▼
/dev/cu.usbmodem...
   │
   ▼
ESP32-S3
То есть тяжёлое SDK-окружение живёт внутри контейнера, а маленькая утилита на хосте занимается только тем, что действительно требует непосредственного доступа к USB-устройству.
Для разработки на Mac это оказалось гораздо приятнее, чем пытаться заставить контейнер полностью владеть физической ESP32.
Здесь окончательно проявилось преимущество simulator-first подхода.
Большую часть backend-разработки вообще не нужно связывать с этим workflow.
┌──── Simulator
                    │
Go Backend ◄────────┤
                    │
                    └──── Real ESP32
Пока я меняю API, работу с устройствами, incidents или другую серверную логику — можно использовать simulator. Docker с ESP-IDF и физическая ESP32 нужны только тогда, когда изменения действительно затрагивают firmware.
Получилось довольно удобное разделение:
Backend development
        │
        └────► simulator


Firmware development
        │
        ├────► Docker + ESP-IDF
        │
        └────► espflash + ESP32


Integration testing
        │
        └────► real ESP32 ──► real backend
Для проекта, который начинался с вопроса «есть ли интернет в офисе?», получился вполне приличный маленький development environment.
На этом эксперимент можно было считать законченным. По крайней мере, до следующей идеи.
Шалость удалась.
Есть ещё один результат проекта, которого я изначально вообще не планировал. После того как первая версия заработала, мне не захотелось закрыть репозиторий и поставить устройство на полку.
Получилось ровно наоборот. Появилось ещё больше желания продолжить эксперимент.
ESP32 отлично справилась с той задачей, ради которой всё начиналось: маленькое устройство постоянно находится в офисе, практически ничего не требует от инфраструктуры и может сообщить внешнему серверу, что сеть доступна.
Но теперь интересно попробовать сделать следующий шаг. Например, собрать уже более полноценный network probe на базе Raspberry Pi. Это будет устройство совсем другого класса.
Если ESP32 в текущей реализации в основном отвечает на бинарный вопрос «могу ли я сейчас выйти из офисной сети наружу?», то с Raspberry Pi можно будет задавать системе гораздо больше вопросов.
ESP32

    сеть доступна?
          │
          └──► да / нет


Raspberry Pi

    сеть доступна?
          │
          ├──► доступен ли gateway?
          ├──► работает ли DNS?
          ├──► доступны ли внешние узлы?
          ├──► какой latency?
          ├──► есть ли packet loss?
          ├──► на каком участке возникает проблема?
          └──► что ещё можно проверить автоматически?
И здесь мониторинг уже начинает постепенно превращаться в диагностику.
Представим, что внешний heartbeat пропал. Сейчас система может уверенно сказать: устройство давно не выходит на связь. Но более функциональный probe перед окончательной потерей связи или после её частичного восстановления мог бы собрать дополнительный контекст.
Например:
Internet unavailable
        │
        ▼
Gateway reachable?
    │          │
   no         yes
    │          │
    ▼          ▼
LAN issue    DNS works?
               │
          ┌────┴────┐
         no        yes
          │          │
          ▼          ▼
      DNS issue   External hosts?
                     │
                ┌────┴────┐
               no        yes
                │          │
                ▼          ▼
           ISP / route   Service issue?
Конечно, реальная диагностика сети значительно сложнее этой схемы. Но именно это и делает продолжение интересным.
Можно постепенно добавлять сценарии проверки, сохранять результаты диагностики вместе с incident, сравнивать поведение разных узлов и пытаться не просто обнаружить проблему, а собрать достаточно информации для её первоначального анализа.
Тогда вместо сообщения «офис offline» со временем можно будет получать более полезную диагностику: «Офис не может выйти в интернет: локальный gateway доступен, DHCP-конфигурация сохранена, DNS-запросы не проходят, внешний узел по IP доступен» или «Устройство не видит даже gateway — вероятнее всего, проблема находится внутри локальной сети».
Это уже совсем другой уровень проекта.
Появляется пространство для сетевых утилит, фоновых диагностических сценариев, накопления метрик и автоматического анализа результатов. Можно экспериментировать с тем, сколько информации устройство способно собрать самостоятельно до того, как человеку вообще придётся подключаться к диагностике.
И мне нравится, что идея следующей версии появилась не потому, что первая была недостаточно хороша.
Наоборот.
Первая версия решила именно ту задачу, ради которой создавалась, а заодно показала, что за простым вопросом «Есть ли интернет в офисе?» скрывается гораздо более интересный: «А если его нет, можем ли мы автоматически понять хотя бы примерно, почему?»
Так что шалость действительно удалась.
Просто, похоже, она ещё не закончилась.
Весь проект я вынес в открытый репозиторий на GitHub — ESP32 S3 Network Monitor.
100 тыс.+ пользователей и 3000 часов разработки — Flutter MVP за 3 месяца
Тысячи скачиваний и шорт-лист Рейтинга Рунета — экосистема доставки еды на Flutter для Пхукета